
Google lance deux nouvelles TPU d'un coup, séparant pour la première fois les puces d'entraînement et d'inférence, et déploie à grande échelle les agents d'IA pour les entreprises

Google Cloud, filiale d'Alphabet, a multiplié les annonces lors de sa conférence annuelle pour développeurs, en lançant simultanément une nouvelle génération de puces propriétaires et des outils de création d'agent AI d'entreprise. Ainsi, la société s'attaque à Nvidia, OpenAI et Anthropic, sur les fronts du hardware et du software.
Mercredi, lors de la conférence Google Cloud Next 2026 à Las Vegas, Google Cloud a présenté deux nouveaux produits de sa huitième génération de processeurs Tensor (TPU) : le TPU 8T, spécialement conçu pour l’entraînement des modèles AI, et le TPU 8i, optimisé pour la phase d’inférence ; leur commercialisation est prévue plus tard dans l’année. C’est la première fois que Google sépare les tâches d’entraînement et d’inférence sur des puces distinctes, marquant un changement majeur dans sa stratégie hardware AI.
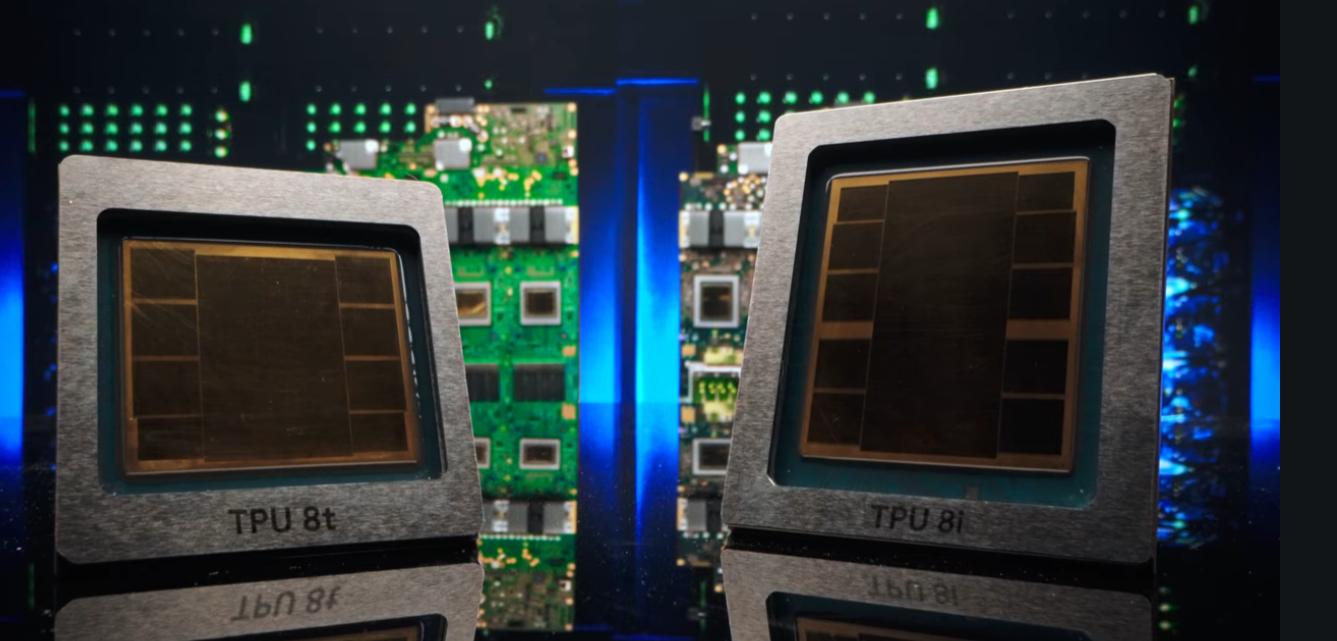
Dans le même temps, Google a lancé une série d’outils de développement d’agents AI, dont la Gemini Enterprise Agent Platform, visant directement le marché de l’automatisation d’entreprise.
Cette sortie de nouvelles puces intervient alors que la demande pour l’inférence AI explose. Mark Lohmeyer, vice-président de Google Cloud Computing et AI Infrastructure, déclare : "L’enjeu est de garantir le plus faible coût par transaction avec la plus basse latence possible. Le volume de transactions croît fortement, et pour atteindre l’échelle, le coût individuel doit chuter." Les deux nouvelles puces seront commercialisées plus tard cette année.
Séparation entraînement et inférence : bond de performance des puces
Google répond directement à la diversification des charges de travail AI en scindant la huitième génération de TPU en deux produits distincts.
Amin Vahdat, vice-président senior et CTO de l’AI et des infrastructures chez Google, écrit sur son blog : "Avec l’essor des agents AI, nous estimons que l’industrie devrait profiter de puces optimisées spécifiquement pour l’entraînement ou pour l’inférence."
Le TPU 8t, conçu pour l’entraînement des modèles AI, promet de "réduire le cycle de développement des modèles avancés de plusieurs mois à quelques semaines".
Côté performance, le TPU 8t affiche une efficacité énergétique par watt supérieure de 124 % à la génération précédente ; le TPU 8i progresse de 117 %. Par rapport au TPU Ironwood Gen7 de novembre dernier, le TPU 8t offre une performance 2,8 fois supérieure à prix égal, tandis que le TPU 8i gagne 80 %.
Le TPU 8t, dédié à l’entraînement, peut rassembler jusqu’à 9600 puces dans un seul système. Google précise qu’à cette échelle, la consommation électrique devient un facteur central dans les centres de données, rendant l’efficacité énergétique cruciale.
Le TPU 8i cible principalement les scénarios d’inférence, idéal pour exécuter des modèles AI et des tâches d’agents AI. Son architecture se distingue par une grande capacité de mémoire embarquée : chaque puce intègre 384 Mo de SRAM, soit trois fois plus que la génération Ironwood précédente.
Les deux puces seront proposées commercialement vers la fin de l’année 2026.
Sundar Pichai, PDG d'Alphabet, a indiqué sur son blog que cette architecture vise à "offrir, de manière économique, un débit massif et une latence ultra-faible pour exécuter des millions d’agents simultanément". L’augmentation de la mémoire embarquée évite d’appeler fréquemment les données externes, ce qui est primordial pour la résolution de tâches AI nécessitant plusieurs étapes de raisonnement.
Plateforme d’agents AI étendue : confrontation directe avec OpenAI et Anthropic
Du côté logiciel, Google dévoile une chaîne complète d’outils pour agents AI d’entreprise, répondant directement à l’offensive d’OpenAI et Anthropic sur ce marché.
Selon Bloomberg, de nombreux fondateurs de startups attestent que les ingénieurs de la Silicon Valley alternent entre Claude Code d’Anthropic et Codex d’OpenAI pour les outils de programmation AI, Google étant rarement pris en compte — une situation inquiétante pour les dirigeants de Google.
Thomas Kurian, PDG de Google Cloud, précise sur son blog : "Il ne s’agit pas de fournir des services individuels assemblables, mais bien un socle d’innovation complet."
La nouvelle Gemini Enterprise Agent Platform apporte les fonctionnalités Memory Bank et Memory Profile, permettant aux agents de mémoriser les interactions passées avec les utilisateurs, comblant les carences de mémoire des premiers outils AI ; la simulation d’agents permet aux développeurs de tester leurs outils avant le lancement.
Google lance également la plateforme collaborative Projects, intégrant Workspace, Microsoft OneDrive et les outils internes de messagerie d’entreprise, fournissant aux agents le contexte nécessaire. Par ailleurs, Google propose l’application Gemini Enterprise à tous les employés, agissant en tant que "réception AI" ; nul besoin de coder pour créer des agents.
Adoption accélérée du TPU, collaboration continue avec Nvidia
Malgré les efforts portés sur ses propres puces, Google continue à collaborer avec Nvidia.
Mark Lohmeyer précise que Google entend être parmi les premiers à déployer les nouvelles puces Nvidia au second semestre, tout en poursuivant la fourniture de services aux clients utilisant les systèmes Nvidia.
Simultanément, l’adoption commerciale des TPU de Google s’accélère.
Le fonds Citadel Securities a déjà fondé ses logiciels de recherche quantitative sur les TPU de Google ; tous les 17 laboratoires nationaux du Département de l’Énergie des États-Unis utilisent un logiciel scientifique collaboratif AI basé sur TPU. Meta a signé un contrat pluriannuel, d’une valeur de plusieurs milliards de dollars, pour utiliser les TPU, tandis que Anthropic s’engage à exploiter plusieurs gigawatts de puissance sur TPU Google.
L’analyste DA Davidson estimait en septembre dernier que l’activité TPU, associée au département AI DeepMind de Google, se valorise à quelque 900 milliards de dollars.
À noter : Google n’a pas directement comparé la performance de ses nouvelles puces avec celles de Nvidia. Nvidia, pour sa part, lancera prochainement une gamme intégrant la technologie acquise lors de son rachat de Groq, pour 20 milliards de dollars, ciblant spécifiquement les scénarios d’inférence ultra-low-latency.
Jensen Huang, PDG de Nvidia, estimait que plus de 20 % des workloads AI pourraient bénéficier de ce type de puce. Groq a été fondée par d’anciens ingénieurs de Google en 2016.
Afin d’élargir l’accessibilité des TPU, Google teste la possibilité de déployer ses puces dans les centres de données clients et développe la compatibilité avec des outils logiciels tiers. Toutefois, l’approvisionnement limité en puces et le décalage entre l’évolution rapide des modèles AI et le cycle de développement pluriannuel des puces restent les principaux défis pour l’expansion de Google à grande échelle.
Avertissement : le contenu de cet article reflète uniquement le point de vue de l'auteur et ne représente en aucun cas la plateforme. Cet article n'est pas destiné à servir de référence pour prendre des décisions d'investissement.
Vous pourriez également aimer

Nomura avertit : les indices boursiers américains sont "gravement déformés", dix actions représentent 70% de la hausse du S&P ; attention à l'impact potentiel du diesel
McElligott estime que le S&P 500 connaît une « prospérité illusoire » : 85 % des actions qui le composent ont déjà corrigé (un sixième ayant perdu la moitié de leur valeur). Plus préoccupant encore, la faible corrélation actuelle des marchés n’a été observée que juste avant la crise financière de 2007 et lors de l’« apocalypse de la volatilité » en 2018. Le marché fait face à deux risques majeurs : premièrement, la déception des revenus d’OpenAI (seulement 30 % des attentes) remet en question la tendance de l’IA ; deuxièmement, le déficit structurel dans le raffinage fait que « l’écart du diesel devient la volatilité des taux d’intérêt », constituant ainsi une bombe à retardement.

Le rendement des bons du Trésor américain à 10 ans approche 5,4 %, l'aura de l'IA ne peut masquer les inquiétudes sur la "surévaluation" du S&P 500
Derrière le nouveau sommet historique du S&P 500, seulement 30 % des composants de l'indice se situent au-dessus de leur moyenne mobile sur 50 jours, marquant le record le plus bas de largeur du marché lors d'un sommet depuis 1990. Le Russell 2000 a chuté cinq semaines consécutives et le rendement des obligations à haut risque a grimpé jusqu'à 15 %. Société Générale avertit : si le rendement des obligations américaines atteint 6 % et que le prix du pétrole monte à 150 dollars, le S&P 500 pourrait chuter de plus de 20 % l'année prochaine. Par ailleurs, certains gestionnaires de fonds performants ont entièrement liquidé leurs positions en IA pour se tourner vers l'énergie, affirmant que l'épuisement des financements signifierait "la fin du jeu".
Les frais de transport des pétroliers atteignent leur plus haut niveau en soixante ans : acheminer un bateau de pétrole des États-Unis vers la Chine coûte plus cher que lancer une fusée !
Le coût de transport d'un baril de pétrole brut a grimpé jusqu'à 41 dollars, atteignant près de la moitié du prix du pétrole, et le tarif d'un seul voyage a parfois suffi à acheter un nouveau pétrolier. La crise au Moyen-Orient a entraîné une pénurie structurelle de capacité de transport dans le détroit d'Ormuz, aggravée par des opérations de transfert de navire à navire qui allongent les cycles de rotation. Ainsi, le fret des VLCC est passé d'une moyenne annuelle de 9,2 millions de dollars à 77 millions de dollars, soit une hausse de plus de 8 fois. Les marges bénéficiaires des raffineurs sont rapidement érodées et le prix moyen des pétroliers d'occasion a atteint un niveau historique, dépassant exceptionnellement celui des navires neufs.

Prix des cryptos
Plus


